人大 Sora 思辩:Sora 到底懂不懂物理世界?
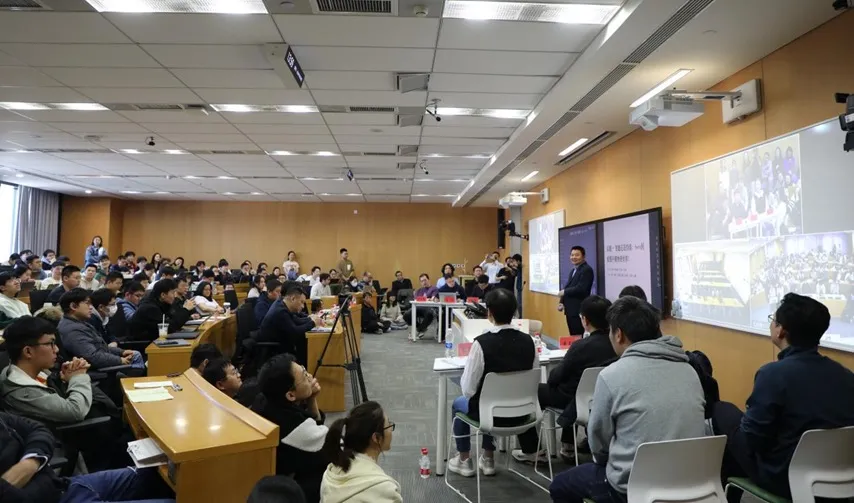
自由PK环节:
正方:
有一种说法是,ChatGPT不懂文字或者不懂语言。但 OpenAI 首席科学家伊利亚依然认为,做 next token prediction,即能够预测下一个词、生成下一个词,这就是理解了语言。伊利亚也举了一个例子,喂给大模型一篇悬疑小说,指令是预测悬疑小说里边的凶手是谁。如果他能够准确地预测出这个凶手是谁,那他到底是不是懂这篇小说?是不是理解这篇小说?
反方:
图灵测试其实是工程的测试,就是说你没有通过图灵测试,你是没有这个能力,但是通过了你未必有这个能力。
以考试为例,如果一位同学没有通过一场考试,这说明这个同学没学懂,但是通过了这场考试并不代表你已经懂了,因为有可能通过用强记的方式把所有的知识记忆下来,所以图灵测试并不具有很强的说服力。
正方:
我恰恰觉得 Sora 是通过图灵测试的,其实图灵测试就两点,第一是要与人比,第二是要用问答。其实 ChatGPT 还是问答的形式,但是 Sora 已经不是了,它其实在做的是一种电影测试。
电影测试,一方面是让人看,生成视频后让人去辨别它有没有错误;另一方面,它不是问答,而是用视觉的方式让人去判断有没有智能。
反方:
什么叫懂物理世界?这个物理必须跟真世界是一致的,部分 AI 可能懂悬疑小说,但他不懂物理世界。如果 Sora 所有的数据数据都来自哈利波特的魔法世界,他一样能预测下一帧,那他能懂物理吗?并不是,它懂的是魔法。
正方:
关于懂物理世界,我方坚持认为达到常人的理解即可不需要懂物理公式。比如在生活中,在马路上来了一辆车,你会用牛二定律去算它是多长时间能到面前吗?并不用,就自己脑补一下,预测未来可能车撞过来了,躲开就 OK 了。这种理解有误差、有偏差,没有关系。
另外,人类对物理的理解也是片面的,不断进步的。不能说现在穿越回去对亚里士德说你根本就不懂物理,我比你懂物理懂得多。也不能说我们现在对物理的理解就是对的。
物理规律是怎么来的?很多时候也是物理学家统计出来的规律,在我们有限的观察下去验证它是不是对的,然后基于我们现在的理解,认为它能解释一些问题,形成的物理规律。但随着时间的演化,人类对物理世界的理解也在加深,一些物理定律也随着观察的增多失效,所以我们不能要求 Sora 一出来,就要求它懂牛二定律,这个肯定不合适。
自由PK环节:
反方 :
我的答案是不能。为什么呢?
从一个角度来看,就是假设说了有两个版本,第一个版本他认为这个世界是不一样的,第二个版本他的参数不一样,他认为这个世界是另外一个样子的。那么现在的一个问题是这两个版本到底哪个是对的?那么只有两种情况,第一种情况是其中一个是对的,另外一种情况就是两个都是错的。所以说从目前的情况来看,我们觉得 Sara 他在认识物理世界的时候,他是有很大的一个偏差的。基于这样的一个极不稳定的一个模型,它版本的更新是不是我们对于这个世界的认识也得跟着它刷新一遍?这个肯定是不合适的,这是第一个。
第二个关于我们对于认识这个世界,除了数据之外,它其实还有模型的一个处理能力,包括我们人也一样,我们人不仅仅有认识这个世界数据的经验,还有我们的理性的处理,也就是说对这个世界的处理能力,数据的处理能力,这个康德已经说的很清楚。
所以如果从这个角度上看的话,Sora不仅要接收来自这个世界不同经验的数据,同时它需要具备像人一样,甚至超过人的理性的思维去处理这些数据,两者缺一不可。
那么如果我们现在从数据的角度来看,Sora目前仅仅介绍了文本、视频和图像,那么我们世界有很多其他的数据,各个领域的数据它通通都没有接触到,所以在数据这个角度AGI已经锁死了它。
第二个,从模型的角度来看,目前它基于Diffusion Model和transformer这种简单的结构,不可能去产生理性的分析以及想象的能力的。所以从模型的处理能力上也锁死了,所以我觉得不管从经验的角度来看,还是从理性分析的角度来看,我觉得AGI都被圈住了。
正方:
我首先要补充下刚刚没有说完的,从效率上讲,Hinton原来是支持人脑非常高效,那应该要模拟一个人脑的,最近他的观念发生了变化,为什么呢?因为人脑非常高效,但是人脑这种大脑它的最大缺陷是我们的交流能力非常差,比如说我要把我的想法传递给大家,效率可低了,但是大模型这种基于数字计算机的这种架构,它在模型之间传递信息的效率非常高,我可以把整个模型的数据拷贝一份,或者我在训练的时候所有梯度去做一个reduce,这个效率比人脑高太多了。
你可以想象大模型在做的是什么呢?是一万个、一亿个跟你一样聪明的人在不断地读书,然后他能获得智能,大家能想象下这是什么水平。
第二个问题回应下两位老师,他们觉得人可能会有一个东西叫做理性,这种理性是人脑所具备的一种内在的能力,而这种能力是进化产生的,然后说现在的模型不具备这样能力,并且现在的模型好像没有进化出这个机制,那你想想我们学院现在在干嘛呢?我们学院在不断地改架构,我们学院在把神经网络进化,没有什么理由认为我们这种操作比大自然的自然选择低效,所以那未来的模型会不会具备人类内在的理性的能力呢?
反方:
刚刚正方辩友的观点恰恰说明你是认可架构的重要性的,而架构本质上它其实并不是纯数据驱动,它其实对应的还是知识。而且回到这个辩题,纯数据驱动能不能实现通用人工智能?如果即使是按照正方辩友讲的,就是一种类人的具有一定通用性的人工智能。
除了效率和资源上会制约这种纯数据的数据路线的发展之外,另外一点重要的就是这种纯数据的路线它归根到底学习到的是统计规律,而统计规律它必然就会两个问题,一个是它的外推,或者说是泛化,或者说是外差的能力,这是统计机器学习里面一直存在的一个困境,也就是它没有这种外推去产生新的知识或者说新的能力,这个是它存在的瓶颈,包括刘老师也是做这个泛化性的研究的。
第二点,不管是架构的演化,还是人大脑的演化,其中除了这种连续的、平滑的过程之外,很重要的一点是突变,这种突变其实并不是通过数据来催化,它是具有高度的随机性跟偶然性的,那这种突变能否用纯数据的方式去驱动?至少这件事情现在还是存疑的。我的观点就是这样。
正方 :
我们反问对方辩友,您在日常的吃饭、睡觉,看电脑、看电视的时候到底是用相关性做决策,还是用因果性做决策?
反方:
这个问题非常好,这个事情如果很重要的话,我会用因果性决策。如果这个事情很随意的话,我自己的决策其实就是随机的。
反方:
我补充一点,我觉得人类理性决策很重要的一个点,仍然是需要从直觉走到反直觉。
正方 :
当你说到直觉反直觉的时候,你也得通过说出话来,你才知道什么叫是这个反直觉和直觉,从这个角度来说,我还是坚持我在第一个辩题时候发表的一个观点,就是正方的观点,生成就是智能。
在生成的时候,我完全可以在我生成的内容里面完成所谓的反直觉,完成所谓的因果推断,完成所谓的关联,就是说你作为一个人,你在这个世界上的时候,你难道不说话,整天在那里面就可以因果发现了吗?你肯定不是,你肯定得通过说话。说话是什么,是数据,你肯定得通过记录,记录是什么,是数据,你肯定得做实验,去做实验也是一个数据,然后记录结果。这些都是什么?都是数据,这些都是纯数据驱动。
反方 :
生成即是智能其实是一个谬论。你生成的东西有可能是完全违反一些实际存在的一些基本认知的,有可能是完全错误的、不存在的,虚幻出来的一个东西。你如果从只是把生成内容这个过程当做是智能的话,这个实际上是个谬论,所以说请对方辩友不要再坚持这么一个观点。
正方:
孙老师,难道你生成的东西就都是对的吗?还有人生成的东西就是对的吗?不对呢,就不是人吗?就不是通用人工智能吗?我想你觉得通用人工智能最高标准,现在通用人工智能的标准应该是和一个人对齐,一个普通人对齐。人也有对错,不是说生成的东西一定要是对的,我方并不持这种观点。
反方:
生成的东西不一定是对的,但是我们必须突破这种直觉性的理解,才能实现我们人的智能。比如说我举一个例子,每天早上都听到公鸡打鸣后太阳就升起了,所以我们就认为太阳是公鸡叫出来的,这是一个谬论。
正方:
Sora 从数据里头一样能学出来,太阳升起来公鸡才会叫啊。我们说到Sora有一个版本跟另一个版本不一样这个问题,但其实人认知也是不一样的,拿一个同样的问题来问我们在座的每一个人,像现在这个问题我们都有不同的见解,但不代表我们的不一样,生成出来的结果就不智能。
反方:
你刚刚说的我们生成的东西是错的,就不是人了。关键是我们能够判断人是具有——如果要类人一样的人工智能,对于特定或者说是很宽泛的一个事物,它是具有判断或者正确与否的依据的,到目前为止,我们没有发现有这个依据。
正方:
大模型有。大模型也在判断正确与否,你说看到Sora生成的视频为什么比别的算法生成的更加流畅,它甚至在变换视角的时候还是有这种三维的一致性的,一定是有一种判断在的。
反方:
判断并不是基于纯数据的方式的,这里面有大量的架构和知识来理解的。
正方:
我反驳一下对方辩友的观点,第一,纯数据驱动跟基于纯架构,架构跟数据并不是两个相互对立的topic,纯数据驱动一般对应的是符号驱动,是理性主义跟经验主义的对立,而不是说纯数据驱动就不需要模型架构了,感觉对方辩友一直在企图用一些跟辩题无关的话题来诡辩。
反方:
我觉得任何问题都需要增加一定的条件,如果我花了很长时间,用了大量数据,以至于整个地球的数据都不足以来训练我的模型,这其实是没有意义的。这在很多科学中都是如此,比如密码学中,如果说花了非常多时间,几十万年,几千万年的时间才能解答这个密码,那这个密码其实就是无解的。
所以我认为在现实世界中一定要加上一个限定词,我要在多少时间内才能把这个问题给解决掉,或者需要多大的资源。但是我的观点其实跟大家可能有点不一样,这个问题我觉得更突出是一个「纯」字,我认为纯数据的驱动,它是不能解决通用人工智能问题的。
架构也是有用的,随着架构的不断优化,那我们在训练数据的时候,可能会使训练的数据量形式的降低,如果我们增加了一些因果的原理,物理的原理,那我们可以把数据训练的成本降低,所以我认为纯数据驱动是不能的,但是数据有一定作用,但是物理驱动或者因果的原理同样发挥着非常重要的作用。
正方 :
我反驳一下对方辩友的两个观点。这个辩题我们就考虑在理想情况下,我们能不能达到 AGI,第二个后面说的纯数据驱动的问题,我就问一下,Sora 算不算纯数据驱动,它有没有用Transformer 架构?
反方:
实际上 Sora 用的 Transformer 架构,Transformer 架构本身也是基于知识去设计的,比如说它里面的几个QVK,实际上是从物理的张量分析里面有一些理论基础在里面去支撑它,然后去设计这个架构的。
我们一直在讲实际上的数据驱动,一定是能够辅助我们去实现通用人工智能,但纯数据驱动不加知识的,不加我们对于客观事件理解的,甚至一些先验的规律的,我们认为这样设计出来的模型是很难去达到一个通用人工智能。我觉得你们对这个议题的理解,纯数据驱动这一块还没有理解很深刻,那么未来人工智能发展可能若干年以后会发现纯数据驱动走不通了,最后又回到了数据加知识驱动,最后实现通用人工智能。
正方 :
如果transformer结构没有数据的话,你的模型参数怎么确定?你能一个结构就能做成Sora那样吗?所以说其实人工智能三起两落,那两落大家现在看来都是因为没有走纯数据驱动的方式,所以我们现在大家坐在一起讨论就是因为有了纯数据驱动的Sora,要不然我们没有讨论这个的意义。
还有刚才很多老师提了计算效率的问题,现在纯数据驱动一个典型方法机器学习,其实考虑的就是泛化性,考虑样本有效性,你能说他没有考虑真正的计算资源该怎么在有限的情况下去计算?而且以后可能会有更大的突破。
我们考虑的是未来,我们考虑未来能不能去实现,那么人类其实就是通过观察数据,包括刚才提到的因果,其实也是数据,反事实数据,还有干预数据,通过数据我们得到一些知识。
我们在讨论这个问题的时候,其实最重要的不是人工智能怎么更强,而是我们怎么跟人工智能一起去和谐共生。那么既然我们处理数据,我们人类不如计算机,为什么我们不让计算机用 AI 去处理,而我们人类去处理一些规则,处理一些公式,处理一些定理,那所以说我们觉得纯数据驱动是实现人工智能,包括有温度的人工智能的一个最终的愿景。
大家怎么看?